20 Minuten Lesezeit
Warum Post-Mortems so oft in Schuldzuweisungen enden
Für alle, die IT-Systeme entwickeln und betreiben, gehört die Nachbesprechung nach einer Störung zum Handwerk: Entwicklerinnen, Site-Reliability-Engineers, Betriebsteams und ihre Führungskräfte. Um diese Nachbesprechung geht es hier, genauer um das Blameless Post-Mortem, die schuldfreie Nachbesprechung eines Incidents, und um die Frage, warum es so oft in Schuldzuweisungen kippt, obwohl alle das Prinzip kennen. Der Artikel erzählt, woher die Idee stammt, von der Unfallforschung in Luftfahrt, Kernkraft und Medizin bis zum Site-Reliability-Engineering bei Google, und er zeigt, was in fast allen Leitfäden fehlt. Wer den Mechanismus versteht, bekommt aus Nachbesprechungen wieder das, wofür sie gedacht sind: Ursachen.
Der Incident ist vorbei. Zwei Stunden Ausfall am Dienstagvormittag, die Hotline lief heiß, der Vorstand hat nachgefragt. Jetzt sitzt das Team im Post-Mortem. Auf der ersten Folie steht in großen Buchstaben „Blameless“. Alle haben das Prinzip schon einmal verteidigt, manche haben es eingeführt.
Nach zwanzig Minuten fällt der erste Satz, der alles kippt: „Ich will niemandem etwas unterstellen, aber das Deployment war ja nicht abgesprochen.“ Die Kollegin, die deployt hat, wird still. Ihr Teamlead erklärt, dass die Absprache sehr wohl stattgefunden habe, nur eben im anderen Kanal. Jemand verweist auf das Monitoring, das ja seit Monaten „ein Problem“ sei. Der Betriebsverantwortliche fühlt sich angesprochen und erklärt, warum.
Eine Stunde später gibt es eine Maßnahmenliste mit sieben Punkten, von denen keiner die eigentliche Ursache trifft. Und drei Menschen, die eine Woche lang nicht mehr miteinander reden.
Ein Incident ist eine Bedrohung
Warum passiert das in Teams, die es besser wissen? Weil das Wissen um ein Prinzip nichts daran ändert, wie ein Nervensystem auf Bedrohung reagiert.
Ein Incident bedroht vieles gleichzeitig: den Ruf des Teams, den eigenen Status, manchmal den Job. Er erfüllt damit mehrere Auslöser, die bei fast allen Menschen Stress erzeugen: Kontrollverlust, Kritik vor Publikum, die Möglichkeit, ungerecht behandelt zu werden. Das Post-Mortem holt diese Bedrohung zurück in den Raum. Alle sitzen da und wissen, dass gleich über einen Fehler gesprochen wird. Die Frage ist nur, über wessen.
Unter Bedrohung reagieren Menschen mit Kampf, Flucht oder Totstellen. Kampf und Flucht hat der US-amerikanische Physiologe Walter Bradford Cannon (1871–1945) schon 1915 in „Bodily Changes in Pain, Hunger, Fear and Rage“ beschrieben. Diese Reflexe setzen in Sekundenbruchteilen ein, und ein Bekenntnis zur Fehlerkultur hat in diesem Moment noch gar keine Gelegenheit zu wirken.
Drei Rollen, ein Raum
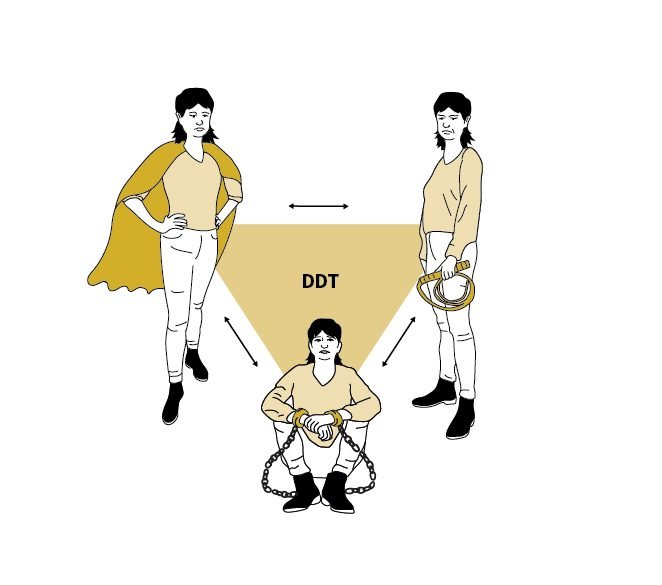
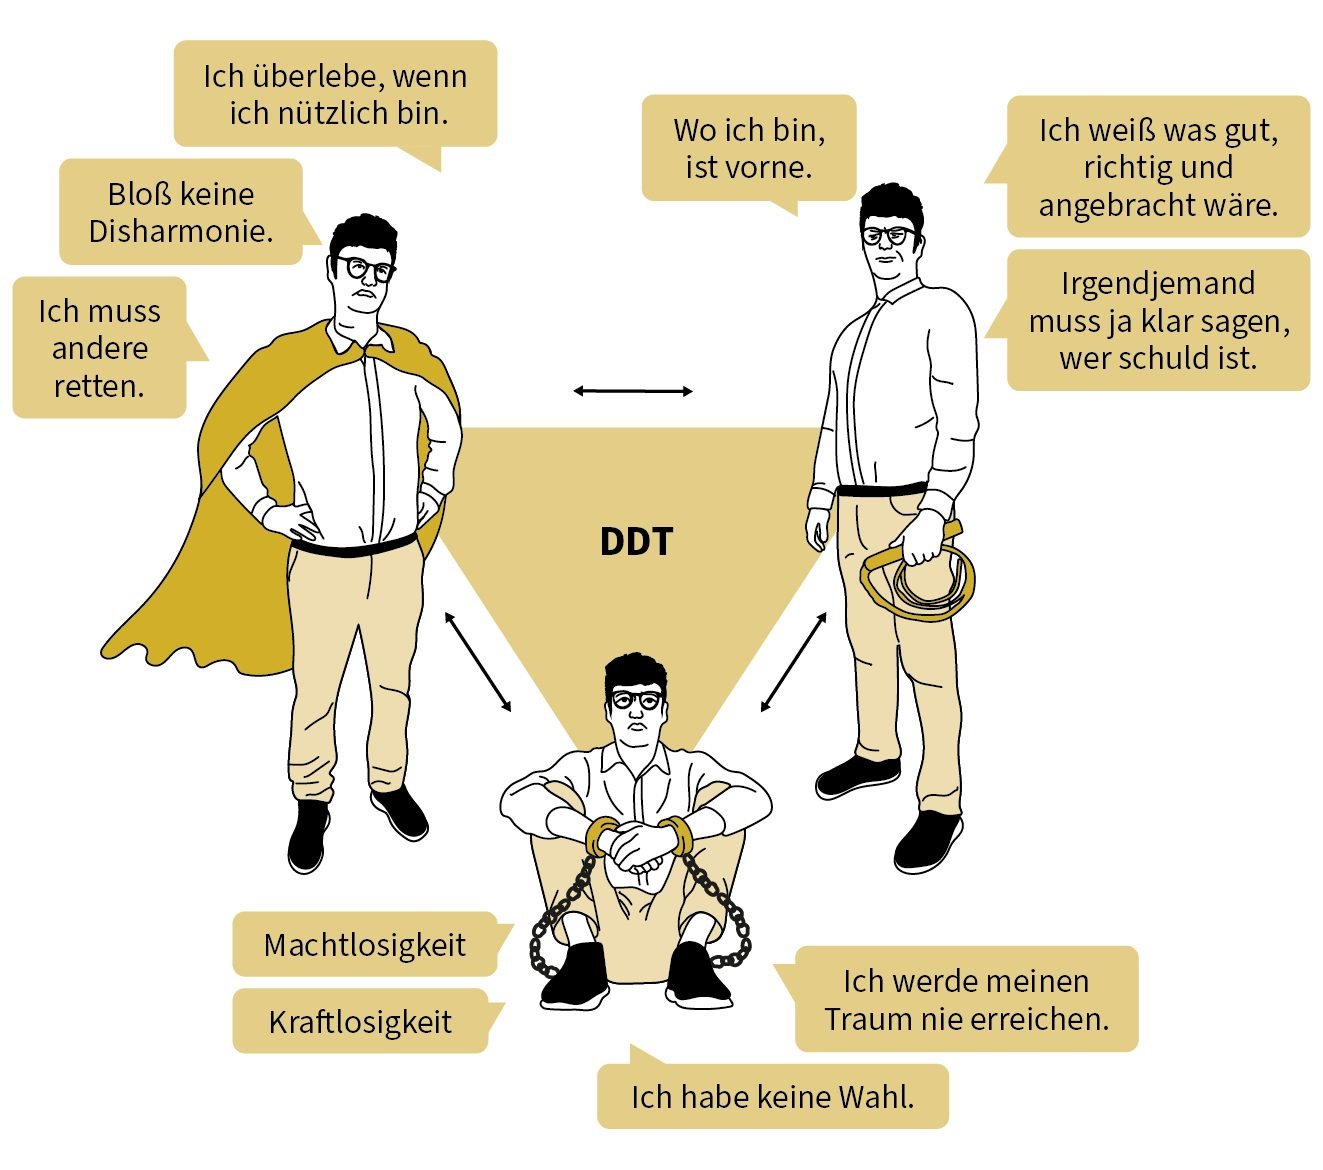
Wie diese Reflexe im Team aussehen, hat der US-amerikanische Psychiater Stephen Karpman (geboren 1942) 1968 mit seinem Drama-Dreieck beschrieben. Karpman arbeitete in der Runde des kanadisch-amerikanischen Psychiaters Eric Berne (1910–1970), der mit der Transaktionsanalyse ein mächtiges, aber sehr komplexes Modell menschlicher Beziehungen geschaffen hatte, das fast nur Fachleute verstanden. Karpman suchte ein Bild, das jeder sofort begreift, und prüfte seine Entwürfe an Fällen aus seiner Arbeit und in Bernes Runde. Er erprobte über dreißig Diagrammformen, bevor er beim Dreieck blieb, und stellte es im Aufsatz „Fairy Tales and Script Drama Analysis“ am Märchen vom Rotkäppchen vor. Im Post-Mortem kann man allen drei Rollen in Reinform zusehen.
- Der Schurke sucht den Fehler bei anderen. Er greift an, weil Angriff die beste Verteidigung ist. „Das Deployment war nicht abgesprochen.“
- Das Opfer zieht sich zurück und überlässt die Deutung den anderen. „Ich hab doch nur gemacht, was im Runbook stand.“
- Der Retter springt ein, um den Frieden zu sichern, und verwischt dabei die Ursache. „Lasst uns nicht über Schuld reden, wir haben alle Fehler gemacht.“
Jede Rolle zieht die nächste nach sich. Der Angriff des Schurken drängt die Betroffene in die Opferrolle. Das Opfer ruft einen Retter auf den Plan. Der Retter macht sich beim Schurken verdächtig, der nun ihn angreift. Das Dreieck dreht sich, und während es sich dreht, hat niemand mehr Kapazität für die Frage, um die es eigentlich gehen sollte: Was hat das System so gebaut, dass dieser Fehler möglich war?
Wo das Blameless Post-Mortem an seine Grenze kommt
Die Idee schuldfreier Post-Mortems ist richtig. In der IT bekannt geworden ist sie vor allem durch die Site-Reliability-Engineering-Praxis bei Google, beschrieben 2016 im gleichnamigen Buch „Site Reliability Engineering“. Ihr Kern: Menschen machen Fehler, weil Systeme sie möglich machen.
Ein Prinzip auf einer Folie verhindert aber keinen Reflex. Wer im Post-Mortem sitzt und sich bedroht fühlt, hört das Wort „blameless“ und glaubt es nicht. Und meistens zu Recht, weil die Menschen im Raum selbst unter Druck stehen und in ihren Rollen reagieren.
Aus der Nähe sieht das so aus: Du sitzt im Post-Mortem und formulierst im Kopf schon deine Verteidigung, bevor überhaupt jemand gefragt hat. Oder du merkst, wie erleichtert du bist, dass diesmal ein anderes Team im Fokus steht. Oder du sagst nichts, obwohl du weißt, dass die Maßnahmenliste am Problem vorbeigeht.
Grundlagen: Woher das Blameless Post-Mortem kommt
Die Idee des Blameless Post-Mortem ist älter als die IT. Sie stammt aus Bereichen, in denen Fehler Menschenleben kosten: aus der Kernkraft, der Luftfahrt und der Medizin. Dort hat man über Jahrzehnte gelernt, dass Bestrafung zu weniger gemeldeten Fehlern führt und damit zu mehr Unfällen. Erarbeitet haben diese Erkenntnis mehrere Forscher, die sich teils gegenseitig zitieren und teils heftig widersprechen. Wer ihre Geschichte kennt, versteht, warum die Frage „Wer ist schuld?“ in der Sicherheitsforschung als die falsche Frage gilt.
Charles Perrow: Unfälle als Eigenschaft des Systems
Am 28. März 1979 kam es im Kernkraftwerk Three Mile Island in Pennsylvania zu einer teilweisen Kernschmelze, und schnell war von Bedienfehlern die Rede. Der US-amerikanische Organisationssoziologe Charles Perrow (1925–2019), der lange an der Yale University lehrte, sah genauer hin. Mehrere kleine Störungen, jede für sich harmlos, waren auf eine Weise zusammengekommen, die in keinem Handbuch stand und die sich aus den Anzeigen im Kontrollraum kaum verstehen ließ.
1984 veröffentlichte Perrow daraus das Buch „Normal Accidents“. Er beschreibt zwei Eigenschaften, die ein System besonders anfällig machen:
- Interaktive Komplexität. Die Teile des Systems wirken auf unerwartete, oft unsichtbare Weise aufeinander ein. Wer an einer Stelle eingreift, löst an einer anderen etwas aus, das er nicht sehen kann.
- Enge Kopplung. Zwischen Ursache und Wirkung liegt wenig Zeit und wenig Puffer. Ein Fehler breitet sich aus, bevor ein Mensch ihn bemerkt.
Wo beides zusammenkommt, sind Unfälle auf Dauer unvermeidlich; Perrow nannte sie deshalb „normal“. Für die IT liest sich das wie eine Beschreibung des eigenen Arbeitsplatzes: Microservices, die einander über Netzwerkaufrufe brauchen, gemeinsame Caches, automatische Deployments und ein DNS-Eintrag, der in Sekunden weltweit gilt. Perrows Botschaft für jedes Post-Mortem lautet, dass die Suche nach dem einen Schuldigen in solchen Systemen das Wesentliche verfehlt.
James Reason: Human Error und das Swiss-Cheese-Modell
Der zweite Denker kam über ein Missgeschick in der eigenen Küche zu seinem Thema. Der britische Psychologe James Reason (1938–2025), von 1977 bis 2001 Professor an der University of Manchester, forschte zunächst über Reisekrankheit und Orientierungsverlust bei Piloten. Anfang der 1970er Jahre löffelte er beim Teekochen Katzenfutter in die Teekanne, während die Katze hungrig neben ihm stand. Reason sah darin einen Versprecher des Handelns: Ein eingeübtes Muster war am falschen Ort gelandet. Von da an sammelte er solche Alltagsfehler systematisch und fragte, nach welchen Regeln sie entstehen. Reason starb am 4. Februar 2025 im Alter von 86 Jahren.
1990 erschien sein Hauptwerk „Human Error“. Reason unterscheidet darin mehrere Arten unsicherer Handlungen:
- Ausrutscher, bei denen die Absicht stimmt und die Ausführung danebengeht, wie beim Katzenfutter in der Teekanne.
- Aussetzer, bei denen ein Schritt vergessen wird.
- Irrtümer, bei denen der Plan selbst falsch ist, obwohl er korrekt ausgeführt wird.
- Regelverstöße, bei denen jemand bewusst von einer Vorschrift abweicht, meist in guter Absicht und unter Zeitdruck.
In der Szene vom Anfang lässt sich die Handlung der Kollegin genau einordnen. Sie hat deployt, ohne sich in dem Kanal abzustimmen, den die anderen erwartet hatten, weil der Termin drückte und ihr die Nachricht im anderen Kanal genügte. Nach Reason ist das ein Regelverstoß, und zwar seine häufigste Form: eine bewusste Abkürzung, genommen in guter Absicht und unter Zeitdruck. Für Reason begann mit dieser Einordnung die eigentliche Untersuchung. Wer wissen will, warum eine Abkürzung in diesem Moment vernünftig erschien, fragt nach den Bedingungen, unter denen sie genommen wurde, und genau dorthin führt seine zweite Unterscheidung.
Reason trennte aktive Fehler, die am sogenannten scharfen Ende geschehen, also dort, wo Menschen direkt mit dem System arbeiten, von latenten Bedingungen. Das sind Entscheidungen, die oft Jahre zuvor weit weg vom Ort des Geschehens getroffen wurden: eine knappe Personalplanung, ein unklares Verfahren, eine Software, deren Warnungen niemand mehr ernst nimmt. Reason verglich sie mit Krankheitserregern, die im System schlummern, bis sich eine Gelegenheit bietet.
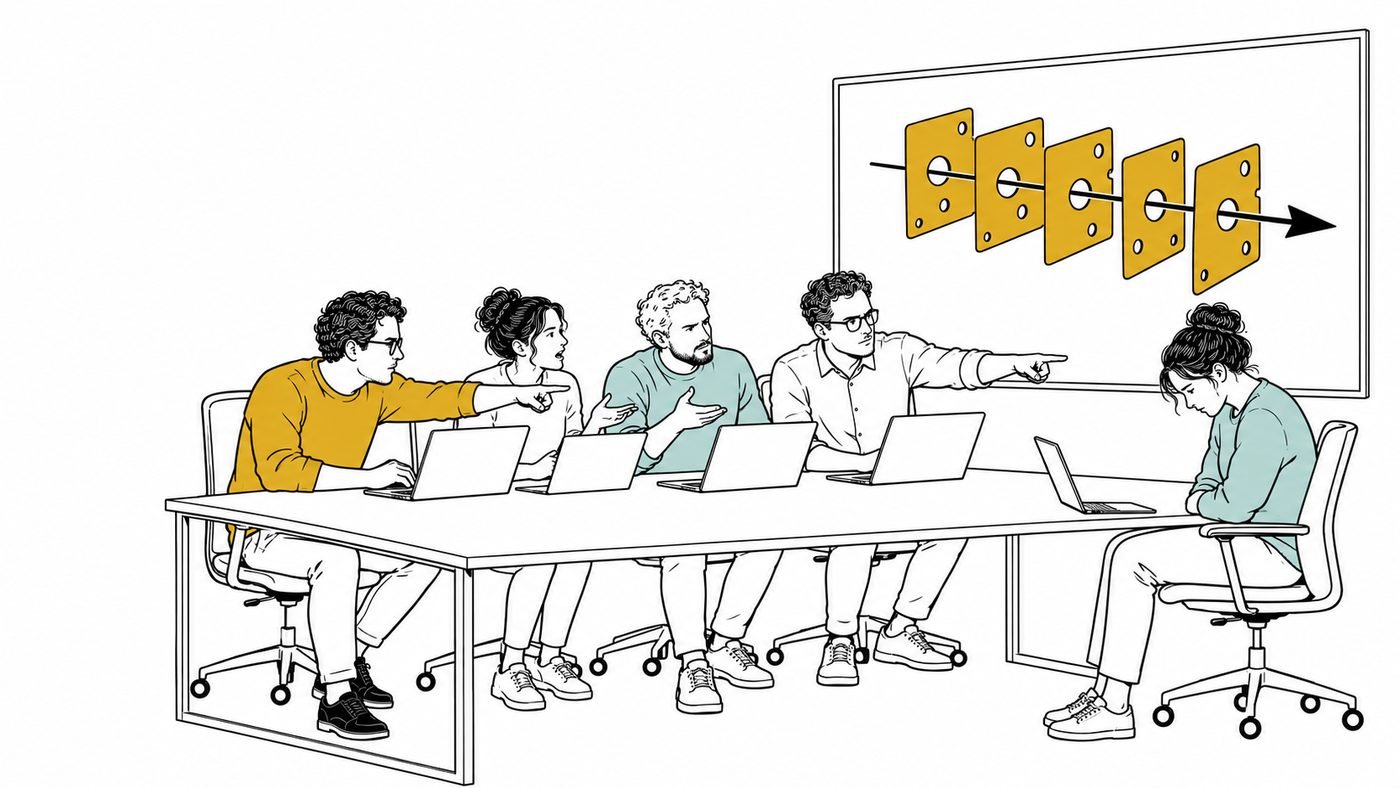
Daraus entstand das Bild, mit dem Reason weltberühmt wurde: das Swiss-Cheese-Modell. Jede Schutzschicht einer Organisation, also Technik, Verfahren, Ausbildung und Aufsicht, ist eine Scheibe Schweizer Käse. Jede Scheibe hat Löcher, und die Löcher wandern. Ein Unfall geschieht erst, wenn die Löcher mehrerer Scheiben für einen Moment in einer Linie liegen. Den Namen gab ein australischer Kollege dem Modell und Reason übernahm ihn gern. Im Jahr 2000 fasste Reason seine Sicht im British Medical Journal zusammen: Der personenbezogene Ansatz sucht die Ursache in Unaufmerksamkeit und Nachlässigkeit des Einzelnen und antwortet mit Ermahnung und Strafe. Der systembezogene Ansatz geht davon aus, dass Menschen fehlbar sind, und fragt, unter welchen Bedingungen sie arbeiten.
Überträgt man das auf die Szene vom Anfang, sieht man die Käsescheiben sofort:
- Das Deployment ohne Absprache ist der aktive Fehler am scharfen Ende.
- Dass Absprachen in zwei verschiedenen Kanälen laufen, ist eine latente Bedingung.
- Das Monitoring, das seit Monaten „ein Problem“ ist, ist eine zweite.
- Ein Runbook, das zum System nicht mehr passt, ist eine dritte.
Die Runde im Post-Mortem spricht über die erste Scheibe. Die Löcher in den anderen bleiben, wo sie sind.
Just Culture: Wo die Linie zwischen Fehler und Fahrlässigkeit verläuft
Sieben Jahre nach „Human Error“ legte Reason „Managing the Risks of Organizational Accidents“ vor und beschrieb darin, was eine Sicherheitskultur ausmacht. Er nannte sie eine informierte Kultur, in der die Verantwortlichen tatsächlich wissen, was in ihrem System vor sich geht. Dafür braucht sie vier Bestandteile:
- Eine Meldekultur, in der Menschen Fehler und Beinahe-Fehler berichten.
- Eine gerechte Kultur, die Just Culture.
- Eine flexible Kultur, die sich unter Druck umorganisieren kann.
- Eine lernende Kultur, die aus den Meldungen Schlüsse zieht und handelt.
Die Just Culture ist das Scharnier. Reason beschrieb sie als Klima des Vertrauens, in dem Menschen ermutigt und sogar belohnt werden, sicherheitsrelevante Informationen weiterzugeben, und in dem zugleich klar ist, wo die Linie zwischen akzeptablem und inakzeptablem Verhalten verläuft. Völlige Straffreiheit hielt er weder für machbar noch für wünschenswert, weil ein kleiner Teil unsicherer Handlungen tatsächlich rücksichtslos ist und alle anderen das sehr genau wissen. Um die Linie zu finden, beschrieb er einen Ersatztest: Hätte eine andere Person mit vergleichbarer Ausbildung in derselben Lage wahrscheinlich genauso gehandelt? Wenn ja, ist Schuld die falsche Kategorie.
Für jedes Blameless Post-Mortem klärt das ein verbreitetes Missverständnis: In Reasons gerechter Kultur bleibt der ehrliche Bericht über einen alltäglichen Fehler ohne Strafe, Konsequenzen für rücksichtsloses Verhalten bleiben möglich.
Richard Cook: Wie komplexe Systeme versagen
Ein Jahr später schrieb ein Mann, der Software und Medizin von innen kannte, vier Seiten, die bis heute in IT-Teams herumgereicht werden. Richard I. Cook (1953–2022), US-amerikanischer Arzt und Sicherheitsforscher, hatte nach dem Studium als Systemanalytiker in der Computerindustrie gearbeitet und Teams von Programmierern geführt, dann Medizin studiert und war Anästhesist geworden. An der University of Chicago leitete er von 1994 an das Cognitive Technologies Laboratory. 1998 verfasste er „How Complex Systems Fail“, achtzehn knappe Thesen auf wenigen Seiten. Einige lesen sich, als hätte Cook sie für ein Post-Mortem geschrieben:
- Komplexe Systeme laufen ständig in einem eingeschränkten Zustand. Irgendetwas ist immer kaputt, und das System funktioniert trotzdem, weil Menschen es ausgleichen.
- Eine Katastrophe braucht mehrere Fehler. Ein einzelner Fehler reicht in einem gut geschützten System nicht aus.
- Die Zuschreibung einer einzigen Grundursache nach einem Unfall ist grundsätzlich falsch, weil der Unfall erst aus dem Zusammentreffen vieler Faktoren entsteht.
- Menschen am scharfen Ende haben eine Doppelrolle: Sie erzeugen die Leistung des Systems, und sie verteidigen es gegen das Versagen.
Die dritte These ist für die IT besonders unbequem, denn viele Post-Mortem-Vorlagen enthalten bis heute ein Feld für die eine Root Cause. Dieses Feld lädt die Runde ein, eine Geschichte mit einem einzigen Schuldigen zu erzählen. Cooks Text wurde 2010 in das Fachbuch „Web Operations“ aufgenommen und landete damit auf den Schreibtischen genau der Menschen, die nachts die Server am Laufen halten.
Sidney Dekker: Rückschaufehler, lokale Rationalität und die Frage, wer die Linie zieht
Am konsequentesten weitergedacht hat Reasons und Cooks Gedanken Sidney Dekker, geboren 1969 in der Nähe von Amsterdam, ein Sicherheitsforscher, der heute an der Griffith University im australischen Brisbane lehrt. Dekker promovierte 1996 an der Ohio State University in Cognitive Systems Engineering, flog später neben seiner Professur als Erster Offizier eine Boeing 737 und gründete an der Universität Lund in Schweden einen Masterstudiengang für Human Factors and Systems Safety.
Mit Reason verband ihn eine lange, freundschaftliche Auseinandersetzung. Als Student hatte Dekker Anfang der 1990er Jahre Reasons Arbeiten studiert, während seiner Promotion wohnte er zeitweise bei Reason zu Hause. Später nannte Reason ihn halb im Scherz einen Emporkömmling, weil Dekker ausgerechnet den Begriff in Frage stellte, auf dem Reasons Werk ruhte. Reason hielt menschliche Fehler für eine eigene Kategorie, die man erforschen und einteilen kann. Dekker sah im „menschlichen Versagen“, wie Cook, ein Etikett, das erst vergeben wird, wenn man das Ergebnis kennt.
In seinem „Field Guide“ von 2002 beschreibt Dekker eine alte und eine neue Sicht auf Fehler. Die alte nennt er die Theorie der faulen Äpfel: Entferne die unzuverlässigen Menschen, und die Fehler verschwinden. Die neue betrachtet den Fehler als Symptom tieferer Probleme im System. Zwei Mechanismen führen Nachbesprechungen nach Dekker regelmäßig in die Irre:
- Der Rückschaufehler. Hinterher wissen alle, wie die Geschichte ausgeht. Deshalb erscheint im Nachhinein jede Entscheidung, die zum Fehler beigetragen hat, offensichtlich falsch. Für die Person, die sie getroffen hat, war sie in diesem Moment eine vernünftige Wahl.
- Die lokale Rationalität. Menschen tun in der Regel das, was in ihrer Situation, mit ihrem Wissen und unter ihrem Zeitdruck sinnvoll erscheint. Wer verstehen will, warum ein Fehler passiert ist, muss diese Sicht rekonstruieren.
Den Rückschaufehler hatte der US-amerikanische Psychologe Baruch Fischhoff, geboren 1946, heute Professor an der Carnegie Mellon University in Pittsburgh, 1975 im Experiment nachgewiesen. Wer den Ausgang eines Ereignisses kannte, hielt ihn für deutlich wahrscheinlicher und glaubte, er hätte ihn vorhersehen können, ohne zu bemerken, dass dieses Wissen sein Urteil verändert hatte. Genau das passiert in jedem Post-Mortem, in dem jemand sagt: „Das hätte man doch sehen müssen.“
2007 folgte Dekkers Buch „Just Culture“. Er übernahm darin Reasons Begriff und stellte ihm eine Frage voran: Wer zieht die Linie zwischen akzeptablem und inakzeptablem Verhalten, mit welchem Wissen und mit welcher Macht? Gezogen wird sie immer hinterher, von Vorgesetzten, Staatsanwälten oder Medien, und damit unter genau dem Rückschaufehler, den Fischhoff beschrieben hat. In späteren Auflagen unterscheidet Dekker eine vergeltende von einer wiederherstellenden Just Culture. Die vergeltende fragt, welche Regel gebrochen wurde, von wem und mit welcher Konsequenz. Die wiederherstellende fragt, wer verletzt wurde, was diese Menschen jetzt brauchen und wessen Aufgabe es ist, das zu leisten.
Amy Edmondson und die Fehlerkultur: Warum gute Teams mehr Fehler melden
Auf denselben Zusammenhang stieß eine Organisationsforscherin durch einen Befund, der zunächst wie ein Messfehler wirkte. Amy C. Edmondson, geboren 1959, US-amerikanische Organisationsforscherin und Professorin für Leadership und Management an der Harvard Business School, untersuchte in den 1990er Jahren Pflegestationen in Krankenhäusern. Sie erwartete, dass gut geführte Stationen weniger Medikationsfehler machen. Gefunden wurden auf den Stationen mit dem besseren Führungsklima aber mehr Fehler.
Edmondson veröffentlichte den Befund 1996 und erklärte ihn mit der Bereitschaft, Fehler zu melden. Wo die Leitung offen mit Fehlern umging, wurden sie berichtet. Wo man Ärger erwartete, verschwanden sie aus den Statistiken. Sie wies selbst darauf hin, dass ihre Daten nicht zeigen konnten, wie viele Fehler tatsächlich passierten, und gerade diese Ehrlichkeit macht die Studie lehrreich: Eine Organisation sieht nur die Fehler, von denen jemand zu erzählen wagt. 1999 gab Edmondson dem Klima einen Namen: psychologische Sicherheit, die geteilte Überzeugung in einem Team, dass man eine Frage stellen, einen Fehler zugeben oder einen Einwand äußern kann, ohne bloßgestellt zu werden.
Für die Fehlerkultur in der IT ist das der Kern. Ein Post-Mortem arbeitet mit dem Material, das die Beteiligten bereit sind zu liefern: Logs, Zeitstempel und die Erzählung darüber, was jemand gedacht hat, als er den Befehl abschickte. Diese Erzählung bekommt nur, wer psychologische Sicherheit hergestellt hat.
Von der Luftfahrt ins Rechenzentrum: Flickr, Etsy und das Incident Review
In die Softwarewelt kamen diese Gedanken vor allem über den technischen Betrieb zweier Internetfirmen. Bei der Fotoplattform Flickr hielt die Betriebsleitung 2009 auf der Konferenz Velocity den Vortrag „10+ Deploys Per Day“, der als einer der Ausgangspunkte der DevOps-Bewegung gilt. 2010 erschien beim Fachverlag O'Reilly der Sammelband „Web Operations“, herausgegeben von zwei Betriebsfachleuten aus dieser Szene, und darin stehen Cooks Thesen.
Am 22. Mai 2012 erschien im Technikblog der Online-Plattform Etsy, geschrieben vom Leiter ihres technischen Betriebs, der Beitrag „Blameless PostMortems and a Just Culture“. Der Text berief sich ausdrücklich auf Dekkers Theorie der faulen Äpfel und formulierte drei Gedanken, die seither in fast jedem Leitfaden stehen:
- Wer im Post-Mortem ohne Angst vor Strafe berichten kann, was er getan, gesehen, erwartet und angenommen hat, liefert genau die Details, die für das Verständnis gebraucht werden.
- Die Person, die den Fehler gemacht hat, ist die beste Expertin für diesen Fehler und sollte an den Verbesserungen mitarbeiten.
- Schuldfreiheit verpflichtet: Die Beteiligten sind gefordert, ihr Wissen einzubringen, damit das System sicherer wird.
Der Verfasser studierte ab 2013 neben seiner Arbeit in dem Masterstudiengang in Lund, den Dekker gegründet hatte, und schrieb dort 2015 seine Abschlussarbeit über Teams, die unter Druck Internet-Ausfälle beheben. 2017 gründete er unter anderem mit Richard Cook die Beratungsfirma Adaptive Capacity Labs. So schließt sich ein Kreis: Der Ingenieur, der Cooks Thesen in ein IT-Fachbuch holte, studierte in Dekkers Studiengang und arbeitete am Ende mit Cook selbst. Seither heißt die Nachbesprechung in vielen Firmen auch Incident Review, und die Haltung dahinter stammt aus Manchester, Chicago und Lund.
Google und das SRE-Buch: Das Blameless Post-Mortem wird Branchenstandard
Zum Standard wurde das Blameless Post-Mortem 2016. In diesem Jahr erschien bei O'Reilly das Buch „Site Reliability Engineering“, in dem Ingenieurinnen und Ingenieure von Google beschreiben, wie das Unternehmen seine Produktionssysteme betreibt. Das Kapitel „Postmortem Culture: Learning from Failure“ nennt das schuldfreie Post-Mortem einen Grundsatz der SRE-Kultur und verweist auf die Herkunft der Idee aus Medizin und Luftfahrt. Weil Google das Buch frei zugänglich machte und viele Unternehmen seine Betriebspraxis übernahmen, verbreitete sich das Verfahren in wenigen Jahren. Mit ihm reisten das Wort und die Post-Mortem-Vorlage. Die Forschung, aus der beides stammt, blieb oft zurück, und daraus entstand das Problem, mit dem dieser Artikel begann.
Erik Hollnagel: Safety-II und die Frage, warum es meistens gut geht
Einen weiteren Schritt ging der dänische Psychologe Erik Hollnagel, geboren 1941, der als Professor in Schweden, Frankreich und Dänemark lehrte und heute emeritiert ist, einer der Begründer des Resilience Engineering. In „Safety-I and Safety-II“ von 2014 beschreibt er zwei Verständnisse von Sicherheit:
- Safety-I versteht Sicherheit als Zustand, in dem möglichst wenig schiefgeht. Untersucht wird, was versagt hat, und die Antwort sind neue Barrieren, Regeln und Kontrollen.
- Safety-II versteht Sicherheit als Fähigkeit, unter wechselnden Bedingungen erfolgreich zu sein. Untersucht wird, wie Menschen sich im Alltag an Unvorhergesehenes anpassen, denn aus derselben Anpassung entstehen die vielen Erfolge und die seltenen Fehler.
Für das Post-Mortem erweitert das den Blick: Dieselbe Art zu deployen, die am Dienstag zum Ausfall führte, hat an zweihundert Tagen davor funktioniert. Wer nur auf den Dienstag schaut, lernt wenig darüber, warum das System sonst trägt.
Wo sich die Denker widersprechen
So einig sich diese Forscher im Grundsatz sind, an vier Stellen widersprechen sie einander:
- Gibt es menschliches Versagen? Reason hielt Fehler für eine erforschbare Kategorie. Dekker und Cook sahen darin ein Etikett der Rückschau. Wer „menschliches Versagen“ als Ursache notiert, beendet die Untersuchung an der Stelle, an der sie interessant würde.
- Wer zieht die Linie? Reason wollte eine klare Grenze zwischen ehrlichem Fehler und rücksichtslosem Verhalten. Dekker hielt diese Grenze für eine Machtfrage.
- Wie viel erklärt ein lineares Modell? Dekker, Cook und Hollnagel wandten gegen das Swiss-Cheese-Modell ein, dass sich in komplexen Systemen Sicherheitsabstände langsam und unbemerkt verschieben, was Dekker 2011 in „Drift into Failure“ beschrieb. Reason räumte ein, dass sein Modell grob ist, und schätzte es, weil Menschen an der Front es verstehen.
- Sind Unfälle unvermeidlich? Perrow hielt sie in eng gekoppelten, komplexen Systemen für unausweichlich. Hollnagel betont, dass dieselben Systeme meistens funktionieren, weil Menschen sich klug anpassen.
Einig sind sich alle in zwei Punkten. Der Blick gehört auf das System, in dem Menschen arbeiten. Und wer Fehler bestraft, bekommt Schweigen.
Was in fast allen Leitfäden fehlt: die Psychologie im Raum
Bei aller Tiefe richten sich diese Ansätze an das Denken der Untersuchenden. Rückschaufehler und lokale Rationalität sind kognitive Phänomene, das Swiss-Cheese-Modell ist eine Denkhilfe, psychologische Sicherheit ist ein Klima, das über Monate entsteht. Was in den Minuten eines Post-Mortems im Nervensystem der Beteiligten geschieht, bleibt in den meisten Leitfäden ein weißer Fleck.
Genau dort setzt das Drama-Dreieck an, und die Brücke lässt sich Rolle für Rolle schlagen:
- Der Schurke vertritt im Raum die alte Sicht, die Dekker beschrieben hat. Wer sagt: „Das Deployment war ja nicht abgesprochen“, sucht den faulen Apfel. Er greift an, weil er selbst unter Bedrohung steht und der Angriff ihm Sicherheit verspricht, solange niemand nach seinem eigenen Anteil fragt.
- Das Opfer erzeugt genau die Lücke, die Edmondson auf den Pflegestationen gefunden hat. Wer verstummt, berichtet nicht mehr, was er gesehen und gedacht hat, und damit fehlt dem Post-Mortem die lokale Rationalität, ohne die es den Fehler nicht verstehen kann.
- Der Retter wiederholt einen Fehler, vor dem Reason gewarnt hat. „Lasst uns nicht über Schuld reden, wir haben alle Fehler gemacht“ ist eine Generalamnestie, die freundlich klingt und die Linie verwischt, die Reason ziehen wollte. Die Runde fühlt sich besser, die latenten Bedingungen bleiben unberührt.
Daraus folgt, wo die Grenze jeder Post-Mortem-Vorlage liegt. Eine Vorlage regelt, welche Fragen gestellt werden. Ob die Antworten ehrlich ausfallen, entscheidet sich im Nervensystem der Menschen, die sie geben. Eine gute Fehlerkultur in der IT braucht deshalb zwei Dinge: das Verfahren, wie es Reason, Dekker, der Etsy-Beitrag und das SRE-Buch beschreiben, und Menschen, die ihre eigene Stressreaktion bemerken, bevor sie das Verfahren unterläuft.
Was möglich ist
Ein Post-Mortem, das wirklich zur Ursache führt, braucht Menschen, die merken, wann sie selbst gerade in eine Rolle springen, und die einen Kollegen aus seiner Rolle holen können, ohne ihn bloßzustellen. Diese Fähigkeit braucht jeder im Raum, die Moderation eingeschlossen.
Dieselbe Szene kann auch anders verlaufen. Derselbe Dienstag, derselbe Ausfall, dieselben Menschen im Raum. Als der Satz über das nicht abgesprochene Deployment fällt, bemerkt der Kollege, der ihn sagt, schon beim Sprechen, wie viel Anspannung in ihm steckt, und hängt eine Frage an: was die Kollegin in diesem Moment vor sich hatte. Die Kollegin bleibt im Gespräch und erzählt, welche Nachricht sie in welchem Kanal abgesetzt hat und warum ihr das genügte. Der Betriebsverantwortliche hört das Wort Monitoring und legt die Zahl der Warnungen auf den Tisch, die seit Monaten niemand mehr ernst nimmt. Angenehm findet das Gespräch niemand. Nach einer Stunde stehen drei Punkte auf der Liste: ein gemeinsamer Kanal für Absprachen, ein Runbook, das wieder zum System passt, und ein Monitoring, dem das Team wieder glaubt. Am Freitag reden alle drei noch miteinander.
Der Selbstlernkurs Dramafreiheit beginnt genau bei dieser Fähigkeit: bei der eigenen Stressreaktion und den Rollen, die sie im Team auslöst. Wer sehen möchte, wie der Kurs aufgebaut ist, findet ihn auf dramafreiheit.de.
Ein Post-Mortem findet die Ursache erst, wenn niemand im Raum mehr damit beschäftigt ist, sich zu schützen.
Quellen
- Allspaw, John: Blameless PostMortems and a Just Culture. Code as Craft, Technikblog von Etsy, 22. Mai 2012.
- Allspaw, John; Robbins, Jesse (Hrsg.): Web Operations. Keeping the Data on Time. O'Reilly, Sebastopol 2010.
- Allspaw, John: Trade-Offs Under Pressure. Heuristics and Observations of Teams Resolving Internet Service Outages. Masterarbeit, Lund University, 2015.
- Beyer, Betsy; Jones, Chris; Petoff, Jennifer; Murphy, Niall Richard (Hrsg.): Site Reliability Engineering. How Google Runs Production Systems. O'Reilly, Sebastopol 2016. Kapitel 15 „Postmortem Culture: Learning from Failure“.
- Cannon, Walter B.: Bodily Changes in Pain, Hunger, Fear and Rage. D. Appleton, New York 1915.
- Cook, Richard I.: How Complex Systems Fail. Cognitive Technologies Laboratory, University of Chicago, 1998.
- Dekker, Sidney: The Field Guide to Human Error Investigations. Ashgate, Aldershot 2002. Ab 2006 als: The Field Guide to Understanding Human Error.
- Dekker, Sidney: Just Culture. Balancing Safety and Accountability. Ashgate, Aldershot 2007.
- Dekker, Sidney: Drift into Failure. From Hunting Broken Components to Understanding Complex Systems. Ashgate, Farnham 2011.
- Edmondson, Amy C.: Learning from Mistakes Is Easier Said Than Done. Group and Organizational Influences on the Detection and Correction of Human Error. The Journal of Applied Behavioral Science 32 (1), 1996, S. 5–28.
- Edmondson, Amy C.: Psychological Safety and Learning Behavior in Work Teams. Administrative Science Quarterly 44 (2), 1999, S. 350–383.
- Fischhoff, Baruch: Hindsight ≠ Foresight. The Effect of Outcome Knowledge on Judgment under Uncertainty. Journal of Experimental Psychology: Human Perception and Performance 1 (3), 1975, S. 288–299.
- Heinze, Holger: Dramafreie Arbeitswelt. Haufe, 2024.
- Hollnagel, Erik: Safety-I and Safety-II. The Past and Future of Safety Management. Ashgate, Farnham 2014.
- Karpman, Stephen B.: Fairy Tales and Script Drama Analysis. Transactional Analysis Bulletin 7 (26), 1968, S. 39–43.
- Perrow, Charles: Normal Accidents. Living with High-Risk Technologies. Basic Books, New York 1984. Überarbeitete Ausgabe Princeton University Press, Princeton 1999.
- Reason, James: Human Error. Cambridge University Press, Cambridge 1990.
- Reason, James: Managing the Risks of Organizational Accidents. Ashgate, Aldershot 1997.
- Reason, James: Human error: models and management. British Medical Journal 320 (7237), 2000, S. 768–770.
Weitere Artikel
- Warum manche Kollegen in der Opferrolle bleiben, obwohl die Lösung auf dem Tisch liegt
- Warum dich Drama Entwicklungszeit kostet, die in keinem Ticket steht
- Warum dein Team bei jeder neuen Technologie erst mal in den Kampfmodus geht
- Warum der Kollege, der immer recht haben muss, eigentlich Angst hat
- Warum „Das haben wir schon immer so gemacht“ eine Totstellreaktion ist
- Was in deinem Team gerade passiert und warum es dir niemand sagt
- Warum der Druck vom Management bei dir landet
- Warum gute Entwickler fliehen, lange bevor sie kündigen
- Der Moment, in dem du aufhörst zu denken